Es el motor que hay detrás de ChatGPT, de Gemini, de Claude y de cualquier agente de IA que conteste un teléfono o un WhatsApp. Entender cómo funciona explica a la vez lo que hace bien y por qué, a veces, afirma con toda tranquilidad algo que no es verdad. Aquí tienes qué es, cómo lee y escribe, cómo se entrena, por qué se equivoca y qué papel tiene dentro de un agente.
En pocas palabras
- LLM viene del inglés large language model, modelo de lenguaje grande.
- No lee palabras sino tokens, trozos de palabra: «caldera» son dos, «cal» y «dera».
- Escribe calculando, token a token, qué es lo más probable que venga después de lo que ya hay.
- Sabe lo que leyó al entrenarse, no lo que pasa en vuestra empresa; eso hay que dárselo en cada respuesta.
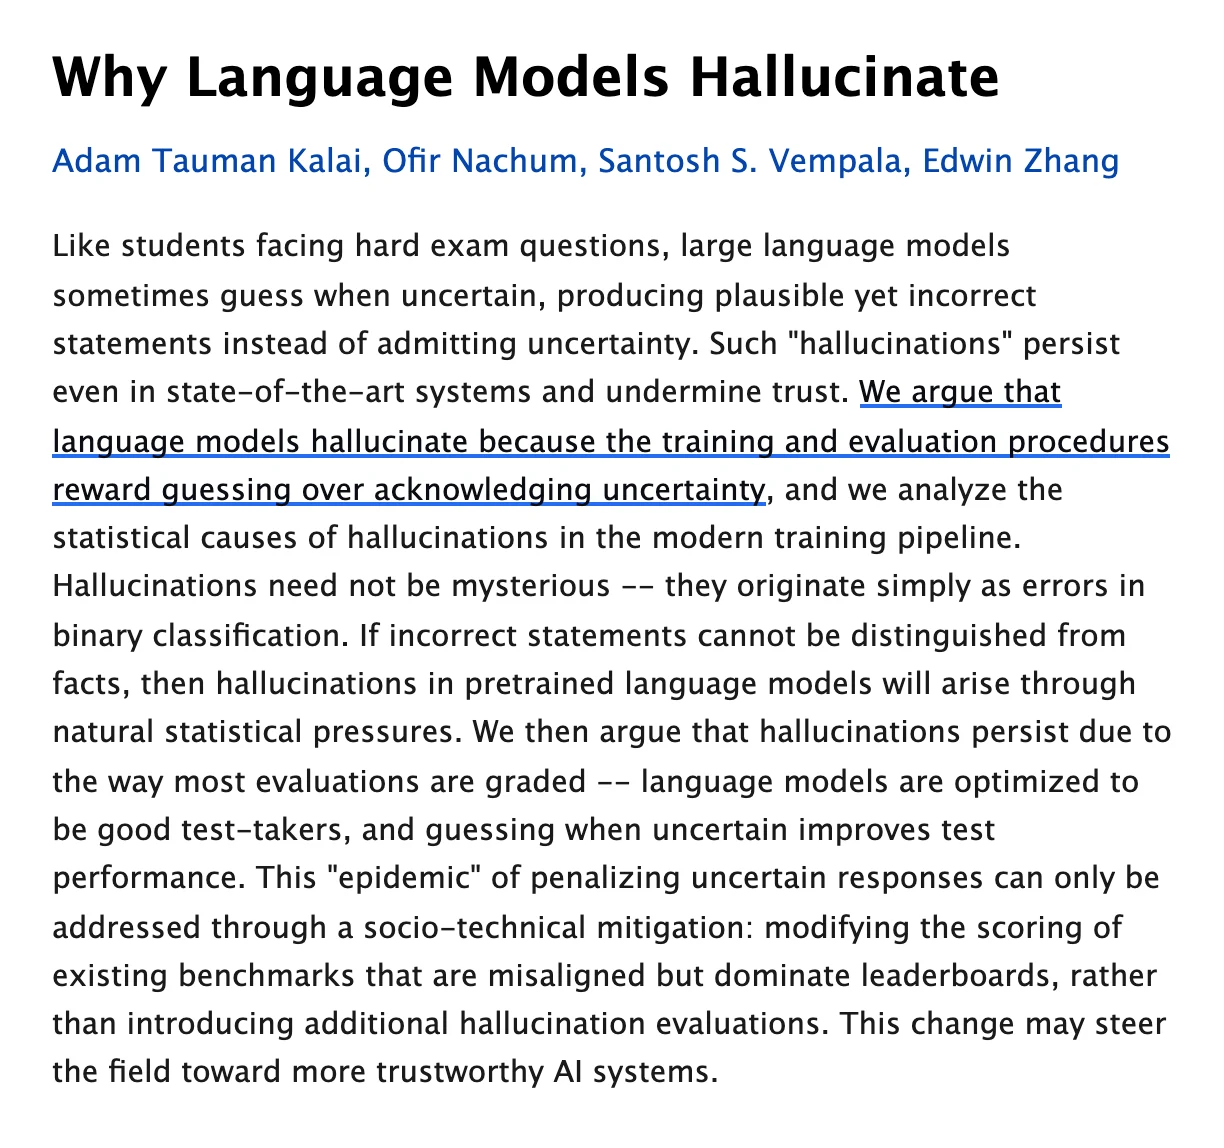
- Se inventa datos porque, según un estudio de 2025, entrenarlo y evaluarlo premia adivinar más que decir «no lo sé».
¿Qué es un LLM?
Un modelo de lenguaje es un programa que, dado un texto, calcula qué es lo más probable que venga después. El curso de aprendizaje automático de Google lo define así: un modelo que estima la probabilidad de que aparezca un token, o una secuencia de tokens, dentro de una secuencia más larga. Con esa sola habilidad, repetida muchas veces, se puede escribir un correo, resumir un parte, traducir un manual o contestar a un cliente.
Lo de «grande» se refiere a dos cosas. A la cantidad de texto con la que aprende, que según IBM son miles de millones o billones de palabras de libros, artículos, webs y código. Y al tamaño del propio modelo, que se mide en parámetros, los números que se ajustan durante el entrenamiento: según Google, los modelos actuales tienen cientos de miles de millones, o incluso billones.
Casi todos se construyen sobre la misma pieza, el transformer, que presentaron investigadores de Google en 2017 en un artículo con un título que se ha hecho famoso, «Attention Is All You Need». Su idea central, la autoatención, consiste en que, para entender cada trozo del texto, el modelo mira cuánto influyen en él todos los demás. Así sabe que en «la caldera del bloque 3 no enciende y su piloto parpadea», «su» se refiere a la caldera y no al bloque.
¿Cómo lee un LLM? Los tokens
Un LLM no lee letras ni palabras enteras, sino tokens: trozos de texto que pueden ser una palabra, una parte de una palabra o un signo. Antes de llegar al modelo, cada frase se parte en tokens con un tokenizador, y cada token se convierte en un número, su posición en el vocabulario del modelo. Así es como lee una frase típica de un aviso, partida con un tokenizador público; debajo de cada token, su número en el vocabulario:
La frase
La caldera no calienta y en la pantalla sale el código E04.
Lo que lee el modelo: 16 tokens
- La4579
- cal2005
- dera100852
- no860
- cal2005
- ienta68342
- y342
- en469
- la557
- pantalla49547
- sale7357
- el650
- código46734
- E457
- 043000
- .13
Fíjate en lo que pasa con «caldera» y «calienta». Ninguna de las dos está entera en el vocabulario, así que el tokenizador las parte, y las dos empiezan por el mismo trozo, « cal», con el mismo número, el 2005. El código de error también se rompe en dos, «E» y «04». El modelo no ve la palabra «caldera»: ve el 2005 seguido del 100852, y ha aprendido de millones de textos que esos dos números juntos tienen que ver con la calefacción.
Los tokens importan por dos razones prácticas. La primera es el precio: los proveedores cobran por token leído y escrito, no por palabra ni por mensaje. La segunda es el límite de lo que puede leer de una vez, la ventana de contexto, que también se cuenta en tokens. Y el idioma cuenta: la misma frase en inglés, «The boiler won’t heat up and the display shows error code E04», son 15 tokens con ese mismo tokenizador, uno menos que en español aunque tiene más letras.
¿Cómo escribe? La palabra siguiente
Para escribir, un LLM hace siempre lo mismo: mira todo el texto que tiene hasta ese momento, calcula la probabilidad de cada token posible para el hueco siguiente, elige uno, lo añade al final y vuelve a empezar. Una respuesta de diez líneas son unos cuantos cientos de vueltas de ese bucle. No hay un plan escrito de antemano: la respuesta va saliendo token a token. Esto es lo que calculó un modelo comercial para el principio de una llamada:
El texto hasta aquí
«Buenos días, le llamo porque la caldera…»
Lo que podría venir después, según el modelo
- no95,8 %
- se2,5 %
- est…0,9 %
- func…0,3 %
- present…0,2 %
«Est», «func» y «present» son tokens que empiezan palabras como «está», «funciona» o «presenta». El modelo da un 95,8 % a «no». Tiene sentido: en casi todo lo que ha leído, quien llama a un servicio técnico diciendo «la caldera» va a decir que no funciona. Pero conviene fijarse en lo que esa cifra no es. El modelo no sabe nada de esta caldera ni de este cliente; sabe cómo suelen seguir las frases que se parecen a esta. Si el cliente llama para pedir una revisión, el modelo habrá apostado mal, y lo habrá hecho con la misma seguridad.
Esa es la clave para entender todo lo demás. Un LLM es extraordinariamente bueno escribiendo lo que es probable que se diga. Que sea verdad es otra cosa, y depende de lo que tenga delante al escribir.
¿Cómo se entrena un LLM?
El entrenamiento tiene dos partes. La primera, el preentrenamiento, es la que lo convierte en modelo de lenguaje: se le dan miles de millones de frases con el final tapado y se ajustan sus parámetros, poco a poco, para que acierte cada vez más qué venía después. Nadie le explica gramática ni le etiqueta nada; IBM lo llama aprendizaje autosupervisado, porque el propio texto hace de corrector. Al terminar, el modelo sabe continuar casi cualquier texto, pero todavía no sabe conversar ni seguir instrucciones.
La segunda parte es el ajuste. Primero se le enseñan ejemplos de instrucciones bien respondidas. Después se usa el aprendizaje por refuerzo con valoraciones humanas, conocido por sus siglas en inglés, RLHF: personas comparan varias respuestas del modelo, las ordenan de mejor a peor, y el modelo se entrena para preferir las que la gente valora más. Es lo que hace que un modelo conteste a la pregunta en vez de continuarla, y que lo haga con un tono útil.
Ese segundo paso pesa más de lo que parece. En el artículo de 2022 que lo popularizó, las respuestas de un modelo de 1.300 millones de parámetros ajustado así gustaban más a las personas que las de uno de 175.000 millones sin ajustar, con cien veces menos parámetros. El tamaño ayuda, pero cómo se ha enseñado a responder cuenta tanto como el tamaño.
¿Qué sabe y qué no sabe?
Un LLM sabe lo que había en el texto con el que se entrenó, y nada más. No sabe lo que ha pasado después de esa fecha, que se llama fecha de corte. Y, sobre todo para una empresa, no sabe nada de lo que no es público: ni vuestras tarifas, ni quién está de guardia este fin de semana, ni qué se le cambió a la caldera de un cliente el mes pasado.
Hay dos formas de dárselo. Una es ponérselo delante en el momento de contestar: buscar en vuestros documentos y en vuestro programa lo que tiene que ver con la pregunta y pasárselo junto con ella. Es lo que se llama RAG, y es lo habitual, porque los datos se pueden cambiar cada día sin tocar el modelo. La otra es ajustar el propio modelo con vuestros textos, el fine-tuning, que sirve más para enseñarle una forma de responder que para que se aprenda datos que cambian.
¿Por qué se inventa datos?
Cuando un LLM da un dato falso con la misma seguridad que uno verdadero se dice que alucina, y no es un fallo raro. El propio curso de Google lo dice sin rodeos: los modelos de lenguaje alucinan, y sus predicciones a menudo contienen errores. IBM lo describe como información falsa o engañosa que suena plausible.
La explicación más clara la dieron en 2025 Adam Tauman Kalai y otros tres investigadores en un artículo titulado, precisamente, «Why Language Models Hallucinate». Su argumento es que se entrenan y se evalúan como un alumno ante un examen tipo test donde no restan los fallos: si no sabe la respuesta, le compensa adivinar antes que dejarla en blanco. Un modelo que dice «no lo sé» saca peor nota que uno que se la juega.
¿Qué hace un LLM dentro de un agente de IA?
Un LLM por sí solo escribe texto. Un agente de IA es un LLM al que se le ha dado un objetivo, unas herramientas y unas reglas. El modelo es la parte que entiende lo que escribe el cliente y decide el paso siguiente: preguntar la dirección, buscar el contrato en el ERP, abrir la orden o pasar el aviso a una persona. Las herramientas son las que hacen esas cosas de verdad, y las reglas marcan lo que no puede hacer nunca.
La diferencia con usar el modelo a pelo está en de dónde salen los datos. Cuando un agente dice que el cliente tiene contrato con atención en 24 horas, ese dato no lo ha «recordado» el modelo: lo ha leído en el ERP un segundo antes. El modelo pone el lenguaje y el criterio; los hechos los ponen vuestros sistemas. Así es como trabajamos en Delegic: el modelo escribe y decide, pero solo afirma lo que ha leído en vuestro programa o en vuestros procedimientos, y lo que no encuentra lo pregunta o lo pasa a una persona.
¿Es lo mismo un LLM que la IA generativa o un chatbot?
No exactamente. IA generativa es el nombre amplio de la IA que crea contenido nuevo: texto, imágenes, audio o vídeo. Los LLM son la parte de la IA generativa que trabaja con texto. Un chatbot es un programa que conversa, y puede llevar un LLM dentro o no: los de antes seguían árboles de menús. Y ChatGPT, Gemini o Claude son productos, aplicaciones con un LLM dentro y una interfaz para hablar con él; el modelo es el motor, y el producto, el coche entero.
Preguntas frecuentes
¿Qué significa LLM?
Son las siglas de large language model, modelo de lenguaje grande. En español también se dice modelo de lenguaje a gran escala, o simplemente modelo de lenguaje.
¿Un LLM entiende lo que lee?
Depende de qué se entienda por entender. Capta muy bien el sentido de un texto, sabe a qué se refiere cada cosa y responde con coherencia. Pero no comprueba si lo que escribe es verdad: escribe lo que es probable. Para un uso de empresa, lo prudente es tratarlo como alguien muy capaz que no conoce vuestra empresa y no sabe decir «no lo sé» si no se le enseña.
¿Aprende de lo que le contamos?
No mientras habla con vosotros: lo que lee en una conversación lo usa para esa respuesta, pero no cambia sus parámetros. Otra cosa es lo que haga el proveedor después con esas conversaciones, que depende de su contrato. Conviene pedir por escrito que no se usan para entrenar modelos.
¿Qué es un parámetro?
Cada uno de los números que el modelo ajusta durante el entrenamiento, y que juntos guardan lo que ha aprendido. Más parámetros suele querer decir un modelo más capaz, pero también más lento y más caro de usar, y no siempre compensa: para coger un aviso no hace falta el modelo más grande del mercado.
Términos relacionados
- RAG: cómo se le dan al modelo vuestros documentos en cada respuesta.
- Alucinación: cuando el modelo da un dato que suena bien pero es falso.
- Ventana de contexto: cuánto texto puede leer el modelo de una vez.
- Agente de IA: un modelo con objetivo, herramientas y reglas.
- Chatbot: un programa que conversa, con un modelo dentro o sin él.