Es lo que permite que un agente de IA diga la tarifa de salida de vuestra empresa, quién está de guardia este fin de semana o qué se le cambió a la caldera de un cliente el mes pasado, cosas que ningún modelo sabe de serie. Aquí tienes qué es, cómo funciona, un ejemplo en un servicio técnico y dónde falla.
En pocas palabras
- RAG viene del inglés retrieval-augmented generation: primero se busca (recuperación) y después se escribe la respuesta (generación).
- Un modelo de lenguaje sabe lo que leyó al entrenarse, no lo de vuestra empresa. RAG le da vuestros documentos en el momento de contestar.
- Funciona en cuatro pasos: llega la pregunta, se busca en los documentos, se junta lo encontrado con la pregunta y se responde.
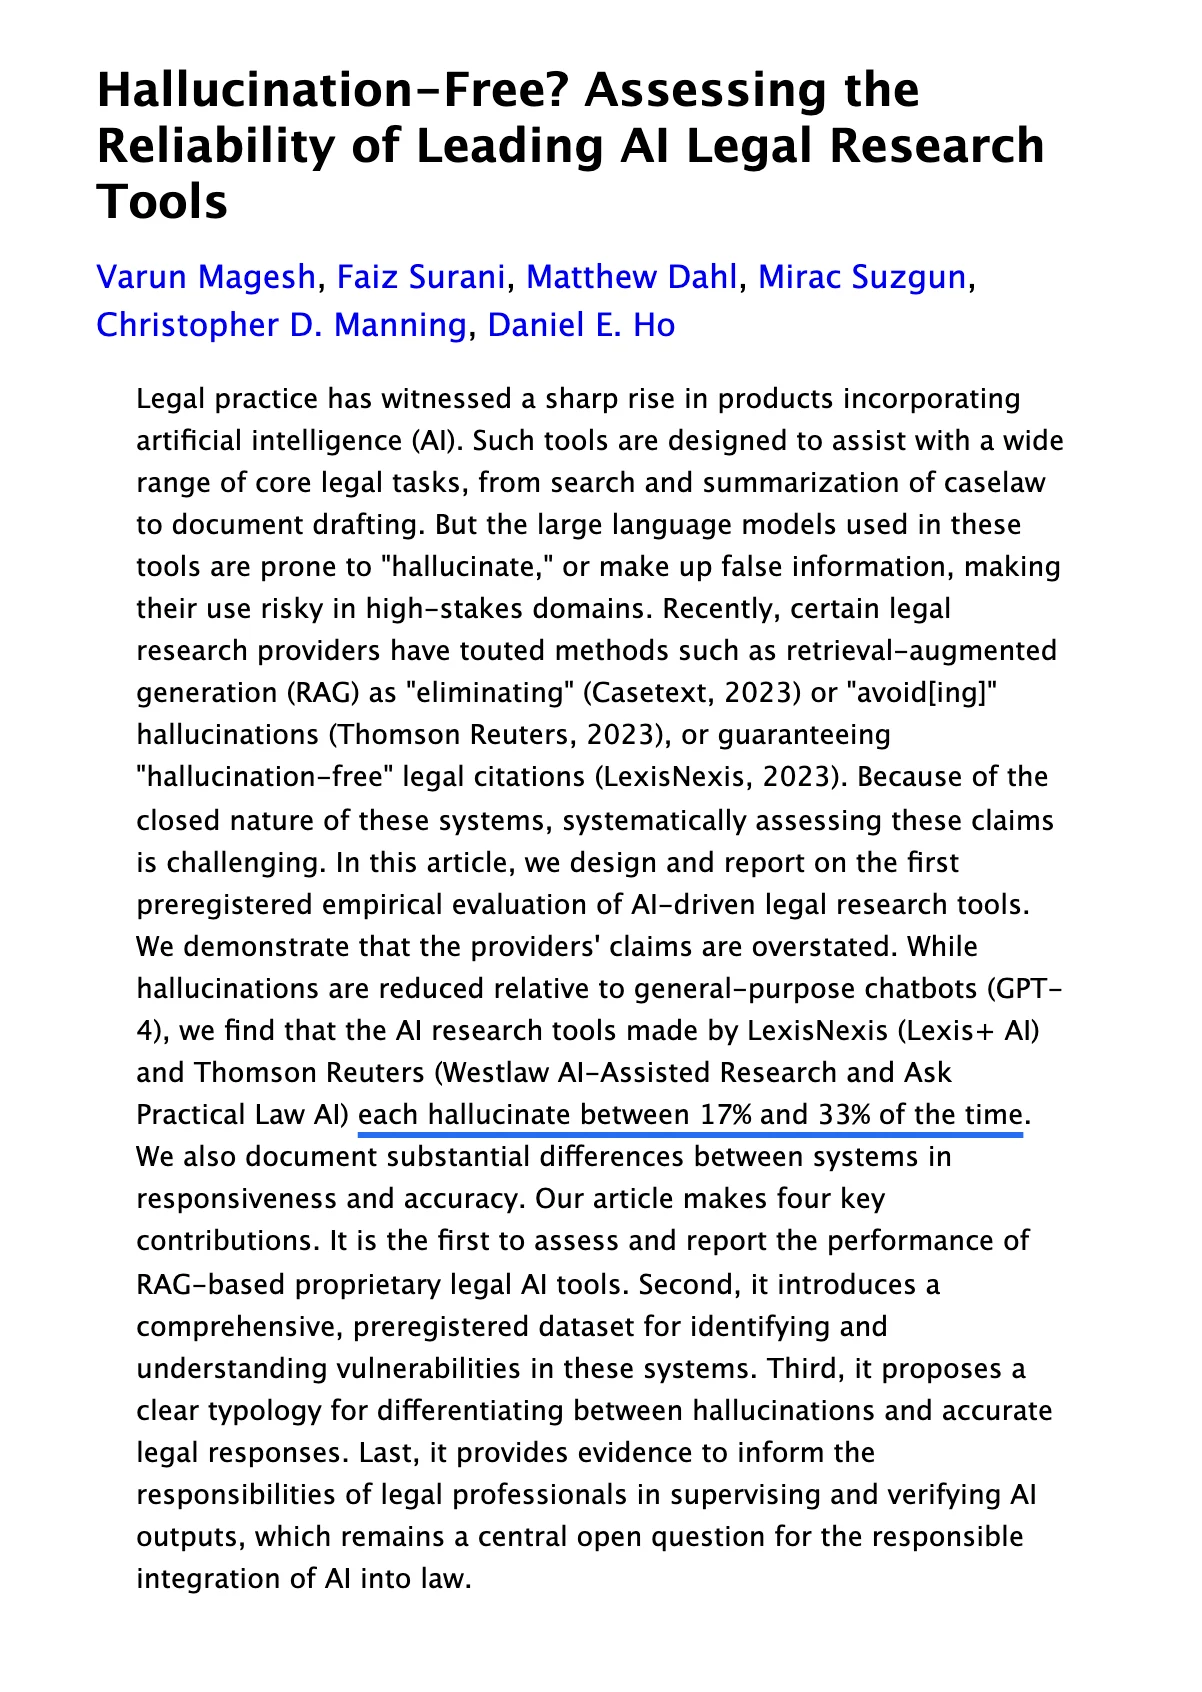
- Reduce las respuestas inventadas, pero no las elimina: un estudio de Stanford midió entre un 17 % y un 33 % en herramientas comerciales con RAG.
- No es lo mismo que el fine-tuning: RAG no cambia el modelo, le da lo que tiene que leer en cada respuesta.
¿Qué es RAG?
Un modelo de lenguaje, el motor de cualquier agente de IA, aprende leyendo una cantidad enorme de texto. Lo que no estaba en ese texto, no lo sabe: ni lo que ha pasado después de entrenarse ni nada de lo que hay dentro de vuestra empresa. Si se le pregunta igualmente, contesta con lo que le parece más probable, y a veces se lo inventa. A eso se le llama alucinación.
RAG lo resuelve sin tocar el modelo. Antes de contestar, el sistema busca en una colección de documentos elegida (vuestros procedimientos, los manuales de los equipos, las fichas del ERP), saca lo que tiene que ver con la pregunta y se lo pone delante al modelo junto con la pregunta. El modelo ya no responde de memoria: responde leyendo.
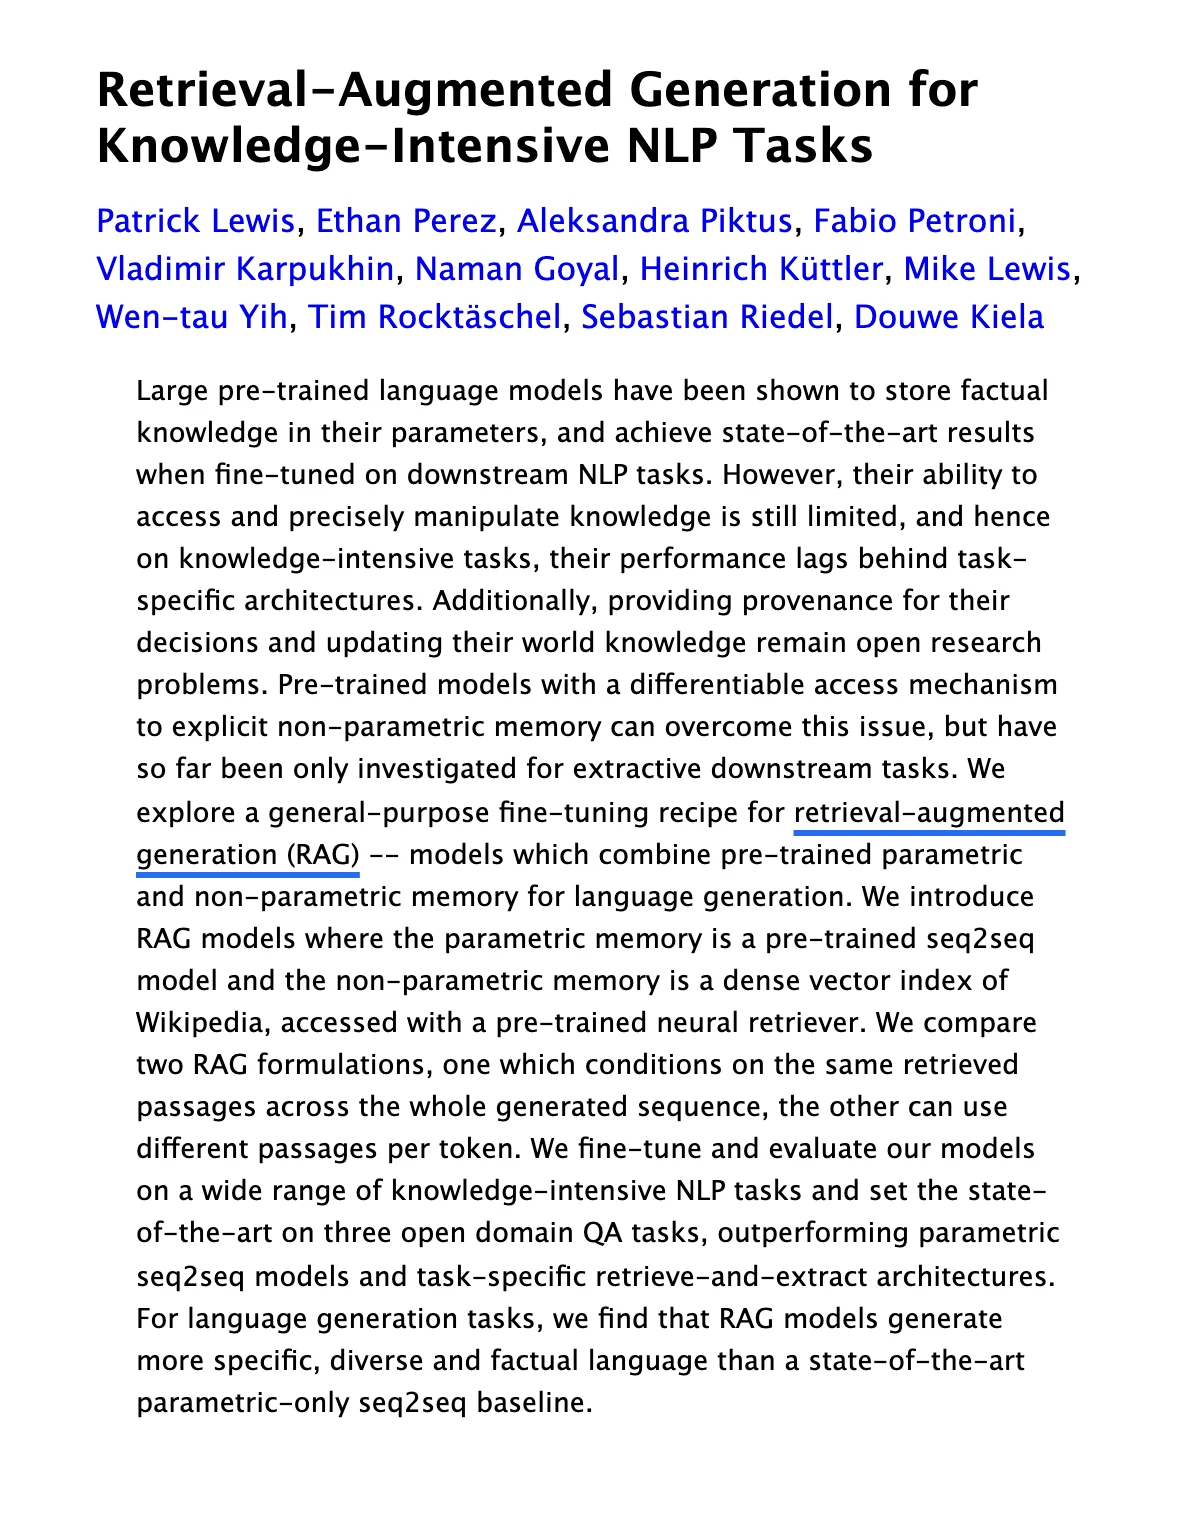
El nombre viene de un artículo de investigadores de Facebook AI Research, University College London y la Universidad de Nueva York, publicado en 2020. Lo que proponían era juntar dos memorias: la del modelo, que guarda lo que aprendió al entrenarse, y una externa, que se consulta en cada respuesta y se puede cambiar sin volver a entrenar nada.
¿Por qué hace falta en una empresa?
Porque lo que hace útil a un agente en una empresa de servicio técnico no es lo que sabe del mundo, sino lo que sabe de vosotros. Casi todo lo que pregunta un cliente se contesta con algo que está escrito en algún sitio de la empresa:
- Lo que dice un procedimiento: si una caldera sin agua caliente un sábado es urgencia, cuánto cuesta la salida y quién está de guardia.
- Lo que dice el ERP: si ese cliente tiene contrato, qué equipos tiene y qué se les hizo en la última visita.
- Lo que dice un manual: qué significa un código de error en un modelo concreto y qué puede comprobar el cliente sin riesgo.
Sin RAG, el agente contestaría con una tarifa media de internet o con lo que suele hacer «una empresa». Con RAG, contesta con la vuestra. Y cuando cambia un documento, la siguiente respuesta ya sale con el cambio, sin reentrenar nada.
¿Cómo funciona RAG, paso a paso?
- 1El cliente pregunta por teléfono, WhatsApp, el chat o el correo.
- 2El agente busca en vuestros documentos y en el ERP lo que tiene que ver con esa pregunta.
- 3Se lo pasa al modelo junto con la pregunta y sus instrucciones.
- 4El modelo escribe la respuesta con lo que ha leído, y el agente contesta.
El paso que da nombre a la técnica es el segundo, y de él depende todo lo demás: si el agente no encuentra el apartado del procedimiento o la ficha del cliente que hacía falta, el modelo contestará igual, con lo que tenga. Bien hecho, además, queda registrado de qué documento salió cada dato, para poder revisarlo.
Un ejemplo en un servicio técnico
Un sábado por la noche escribe por WhatsApp un cliente de una empresa de calefacción. Es un caso inventado, con el recorrido de un aviso real. Esto es lo que le contesta el agente, y de dónde ha sacado cada dato:
El cliente, por WhatsApp, un sábado a las 22:10
«La caldera no calienta y en la pantalla sale un código de error.»
La respuesta del agente
Ese código suele ser falta de presión1: ¿puede mirar el manómetro de la caldera y decirme qué marca? Como tiene contrato con atención en 24 horas2, le dejo el aviso como urgencia3 para el técnico de guardia, y le aviso de que es la misma avería que hace tres semanas2.
- 1Manual del modelo, apartado de códigos de error.
- 2Vuestro ERP, la ficha del cliente: su contrato y el historial de su caldera.
- 3Procedimiento de guardias: «sin calefacción y con contrato, es urgencia».
El técnico de guardia sale sabiendo lo que se va a encontrar, y el cliente ya tiene respuesta. Ninguno de esos datos estaba en el modelo. Todos estaban en la empresa.
Qué documentos sirven, y cuáles estropean las respuestas
RAG es tan bueno como lo que lee. Si un procedimiento está desactualizado, el agente dará la tarifa del año pasado con toda la seguridad del mundo, y además con su fuente.
Lo que sirve: un procedimiento por tema (guardias, tarifas, zonas, urgencias), una sola versión vigente de cada cosa, manuales en PDF con texto, los datos del cliente leídos del ERP en el momento y frases claras, del tipo «sin calefacción y con contrato es urgencia».
Lo que estropea las respuestas: un documento de 80 páginas que lo mezcla todo, dos tarifas sin decir cuál vale, escaneos torcidos, una copia en Excel del ERP de hace seis meses y frases como «según el caso» o «lo decide el encargado».
La regla práctica: si una persona nueva en la oficina no podría contestar leyendo ese documento, el agente tampoco.
Los límites de RAG: no elimina las alucinaciones
RAG reduce mucho las respuestas inventadas, pero no las quita. El mejor estudio independiente que hay lo hizo el RegLab de la Universidad de Stanford en 2024, con más de 200 preguntas preparadas de antemano a las herramientas jurídicas de LexisNexis y Thomson Reuters, que se anunciaban como «libres de alucinaciones» gracias a RAG. Resultado: se equivocaban menos que un chatbot general, pero se inventaban algo entre el 17 % y el 33 % de las veces.
Los fallos de un sistema con RAG casi siempre son de uno de estos tres tipos:
- No encuentra el trozo que hacía falta y contesta con lo que tiene, que no era.
- Encuentra uno viejo o equivocado, porque había dos versiones del mismo documento.
- Lo encuentra, pero lo lee mal: mezcla dos apartados o saca una conclusión que el texto no dice.
Por eso un agente serio no se pone a funcionar sin probarlo antes con casos reales de la empresa, está hecho para decir «no lo sé» y pasar a una persona cuando no encuentra la respuesta, y guarda qué consultó en cada respuesta, para que la oficina pueda revisarlo.
RAG frente a fine-tuning y frente a meterlo todo en el prompt
Hay tres formas de que un modelo sepa cosas de vuestra empresa, y se confunden a menudo:
| Comparación | RAGLo habitual en un servicio técnico | Fine-tuning | Todo en el prompt |
|---|---|---|---|
| Qué es | Busca lo necesario en cada respuesta | Se vuelve a entrenar el modelo con vuestros ejemplos | Se le pasan todos los documentos en cada respuesta |
| Para qué sirve | Datos que cambian: tarifas, guardias, clientes | Un estilo o un formato fijo | Pocos documentos y cortos |
| Si cambia un dato | Se cambia el documento y ya está | Hay que volver a entrenar | Se cambia el documento y ya está |
| Se ve de dónde sale | Sí | No | A medias |
| Coste | Bajo por respuesta | Caro de preparar | Sube con cada documento |
Para una empresa de servicio técnico la respuesta casi siempre es RAG: lo que el agente tiene que saber cambia cada semana, y lo que importa es poder comprobar de dónde ha sacado cada dato. El fine-tuning tiene sentido para otra cosa, como que el modelo escriba siempre con un formato concreto.
RAG clásico y RAG con un agente
El RAG que se explica en casi todas partes es el clásico: los documentos se trocean en fragmentos, cada fragmento se convierte en una lista de números que representa su significado (un embedding) y se guarda en una base de datos vectorial. Cuando llega una pregunta, se buscan los fragmentos con los números más parecidos y se le pasan al modelo.
Con los agentes de IA ha aparecido otra forma: en vez de buscar a ciegas por parecido, el agente ve un índice de lo que hay y decide él qué abrir, como haría una persona con una carpeta de procedimientos. Pide el documento o el apartado que necesita, lo lee y, si no le basta, abre otro.
Con miles de documentos, la búsqueda por parecido es la única forma práctica. Con decenas, el índice tiene una ventaja: el agente no se queda con un trozo suelto que se parece a la pregunta, lee el apartado entero que la contesta.
Cómo lo hace Delegic
Los agentes de Delegic usan la segunda forma. Cada documento de la empresa lleva una línea de cuándo hay que leerlo, que escribe quien lo escribe («léelo cuando pregunten por precios o por la salida»), y los largos van con sus apartados. El agente lee ese índice, abre solo lo que necesita para cada conversación y consulta en vuestro ERP al cliente y sus equipos. Qué consultó queda guardado en cada conversación. Lo cuenta con más detalle qué es un agente de IA, y cómo se aplica a los avisos, atención al cliente.
Preguntas frecuentes
¿Qué significa RAG?
Retrieval-augmented generation, en español generación aumentada por recuperación: una respuesta escrita por un modelo de IA (generación) a partir de información que se ha buscado antes (recuperación).
¿RAG es lo mismo que un chatbot?
No. Un chatbot es lo que habla con el cliente; RAG es una forma de que lo que diga salga de vuestros documentos. Un chatbot puede usar RAG o no, y un agente de IA casi siempre lo usa.
¿Con RAG se entrena la IA con nuestros datos?
No. RAG no cambia el modelo: los documentos se leen en el momento de contestar. Si se borra un documento, deja de usarse en la siguiente respuesta.
¿RAG evita todas las respuestas inventadas?
No. Las reduce, pero un sistema con RAG puede no encontrar el dato, encontrar uno viejo o leerlo mal. Por eso hay que probarlo con casos reales y hacer que pase a una persona cuando no está seguro.
¿Qué documentos hacen falta para empezar?
Los que ya tiene la oficina: el procedimiento de urgencias y guardias, las tarifas y las zonas. Con eso y el ERP se contesta la mayoría de lo que preguntan los clientes.
Términos relacionados
- Alucinación: cuando el modelo da un dato que suena bien pero es falso.
- Modelo de lenguaje (LLM): el motor que escribe la respuesta.
- Base de conocimiento: los documentos que lee el agente.
- Embeddings y base de datos vectorial: las piezas del RAG clásico.
- Ventana de contexto: cuánto texto puede leer el modelo de una vez.