Si alguna vez has visto el precio de un modelo de IA, estaba en tokens: tanto por millón de tokens de entrada y tanto por millón de salida. Y si has leído que un modelo «acepta un millón de tokens», es lo mismo. El token es la unidad con la que se mide todo en un modelo de lenguaje. Aquí tienes qué es, cuánto texto es, un ejemplo medido con un aviso en seis idiomas y por qué le importa a una empresa.
En pocas palabras
- Un token es un trozo de texto: una palabra corta, una parte de una palabra larga o un signo.
- Según Google, en inglés un token son unos 4 caracteres, y 100 tokens, unas 60 u 80 palabras.
- El mismo aviso ocupa 39 tokens en inglés, 44 en español y 48 en catalán, con el mismo tokenizador.
- Las fotos y el audio también se cuentan en tokens: una foto pequeña, 258; un segundo de audio, 32, en los modelos de Google.
- Los tokens deciden el precio, cuánto cabe en la ventana de contexto y cuántas peticiones por minuto se pueden hacer.
¿Qué es un token?
Un modelo de lenguaje no lee letras ni palabras, sino tokens. La documentación de Microsoft los describe como palabras, grupos de caracteres o combinaciones de palabras y signos de puntuación, en los que un tokenizador parte el texto antes de que llegue al modelo. El conjunto de todos los tokens que conoce un modelo es su vocabulario, y cada uno tiene un número. La guía de Google lo resume así:
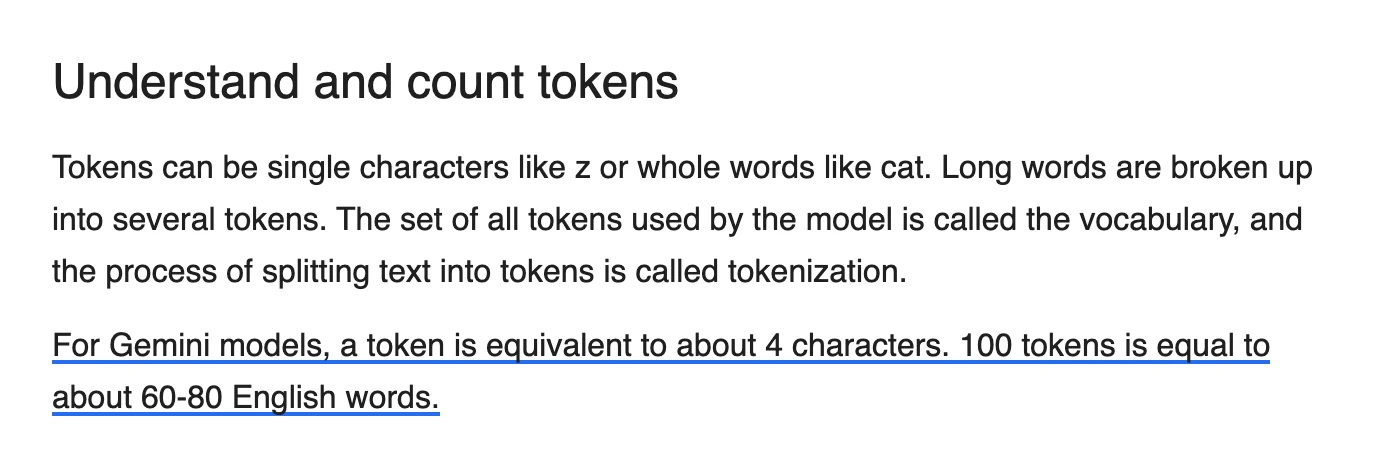
Las palabras comunes suelen ser un token, y las largas o raras se parten en varios. Cómo se parte una frase concreta, token a token y con el número de cada uno, está en la página del LLM: allí «caldera» sale en dos trozos, «cal» y «dera».
¿Ocupa lo mismo en todos los idiomas?
No, y se nota en el precio. La regla de los 4 caracteres de Google habla de palabras en inglés, y en otros idiomas la cuenta cambia. Lo hemos medido: tradujimos un aviso típico a seis idiomas y contamos sus tokens con el mismo tokenizador público.
«Buenos días, la caldera de la comunidad no enciende desde anoche…», en seis idiomas
- Inglés152 caracteres39 tokens
- Portugués136 caracteres43 tokens
- Español154 caracteres44 tokens
- Francés171 caracteres47 tokens
- Alemán184 caracteres47 tokens
- Catalán147 caracteres48 tokens
En inglés son 39 tokens; en español, 44, un 13 % más; y en catalán, 48, un 23 % más, aunque el texto catalán tiene menos letras que el inglés. En español salen unos 3,5 caracteres por token, frente a 3,9 en inglés. Para un aviso suelto da igual; para miles de conversaciones al mes, un 13 % más de tokens es un 13 % más de factura por la misma conversación.
No todo se parte igual. «Boiler» es un solo token; «caldera» son dos, «cal» y «dera»; y el alemán «Heizkessel», tres. Los códigos de error y los números también se trocean: «F28» son dos tokens, «F» y «28», en las seis versiones.
¿Y las fotos o las llamadas?
Los modelos que entienden más que texto, los multimodales, también lo cuentan todo en tokens. La guía de Google lo detalla para sus modelos: una imagen de 384 píxeles o menos por lado son 258 tokens, y una más grande se parte en cuadros de 768 por 768 píxeles, a 258 tokens cada uno. El audio va a 32 tokens por segundo, así que una llamada de tres minutos son 5.760 tokens, y el vídeo, unos 100 por segundo con la resolución por defecto.
En un servicio técnico eso tiene uso diario: la foto de la placa de características que manda un cliente por WhatsApp o la grabación de una llamada que se quiere resumir. Cada una tiene un coste en tokens, como el texto.
¿Por qué importan?
Por tres cosas, que Microsoft explica en la misma página. La primera es el precio: los servicios de IA generativa suelen cobrar por tokens, y el coste de cada petición depende de los tokens de entrada y de salida, que pueden tener precios distintos. La segunda es el límite: cada modelo tiene un máximo de tokens que puede manejar a la vez, la ventana de contexto, que suma lo que lee y lo que escribe. La tercera es el ritmo: los servicios ponen un máximo de tokens por minuto, así que un pico de conversaciones puede chocar con ese techo.
¿Qué tiene que mirar una empresa?
Si contratáis un agente hecho, normalmente no veréis tokens: veréis un precio por conversación, por aviso o al mes, y los tokens son cosa del proveedor. Aun así conviene saber dos cosas. Que el precio por consumo sube con el tamaño de las instrucciones y de los documentos que se le pasan en cada respuesta, y que las fotos y las llamadas cuentan mucho más que un mensaje de texto.
Si lo montáis vosotros sobre un modelo, el cálculo es sencillo: cuántas conversaciones al mes, cuántos mensajes cada una, cuántos tokens lee el modelo en cada respuesta y el precio por millón que publica el proveedor. Y en español, contad con algo más de tokens que en los ejemplos en inglés.
Preguntas frecuentes
¿Cuántas palabras son 1.000 tokens?
En inglés, según la regla de Google, entre 600 y 800 palabras. En español son algo menos: en nuestro aviso, 29 palabras ocupan 44 tokens, unos 1,5 tokens por palabra, lo que da unas 650 palabras por cada 1.000 tokens. Es una estimación con una sola frase; cada texto da una cifra distinta.
¿Un token es una palabra?
A veces. Las palabras cortas y comunes suelen ser un token; las largas, las raras, los números y los códigos se parten en varios. Un signo de puntuación también puede ser un token.
¿Es lo mismo que un token de seguridad?
No. En IA, un token es un trozo de texto. La misma palabra se usa para otras cosas sin relación: el código que identifica a un usuario en una aplicación o una criptomoneda, por ejemplo.
¿Por qué se cobra por tokens y no por palabras?
Porque es lo que procesa el modelo de verdad: el trabajo de calcular cada respuesta crece con los tokens que lee y que escribe, no con las palabras o los mensajes.
Términos relacionados
- LLM: el modelo que lee y escribe en tokens.
- Ventana de contexto: cuántos tokens puede manejar a la vez.
- Prompt: las instrucciones que se leen, y se pagan, en cada respuesta.
- Embeddings: los números que representan el significado de un texto.
- Multimodal: un modelo que también lee fotos y audio.