«¿Se puede entrenar la IA con nuestros datos?» es de las primeras preguntas que hace una empresa cuando piensa en un agente. El fine-tuning es, literalmente, eso: entrenar un modelo con vuestros ejemplos. Pero casi nunca es lo que hace falta para que un agente sepa vuestras tarifas o quién está de guardia. Aquí tienes qué es, cómo funciona, para qué sirve, para qué no y cuándo compensa.
En pocas palabras
- Fine-tuning, en español ajuste fino, es seguir entrenando un modelo ya hecho con ejemplos de una tarea concreta.
- Cambia el modelo por dentro, sus pesos; el prompt y el RAG solo cambian lo que lee en cada respuesta.
- Sirve para enseñar una forma de responder: un tono, un formato, una tarea que se repite mucho.
- No sirve para que sepa datos que cambian, como tarifas, guardias o el contrato de un cliente; Microsoft lo dice expresamente.
- Tiene costes de entrenamiento y de mantenimiento, y sus beneficios no están garantizados: hay que medirlos.
¿Qué es el fine-tuning?
Un modelo de lenguaje se entrena primero con una cantidad enorme de texto general. El fine-tuning es un segundo entrenamiento, mucho más pequeño, que parte de ese modelo ya hecho y lo ajusta con ejemplos de una tarea concreta. IBM lo define como el proceso de adaptar un modelo preentrenado a tareas o usos específicos, y la gracia está en no empezar de cero: se aprovecha todo lo que el modelo ya sabe y solo se le enseña lo que falta.
La diferencia con las otras formas de adaptar un modelo es dónde se mete lo que se le enseña. La documentación de Microsoft lo resume en una frase: el fine-tuning ajusta los pesos del modelo, en lugar de añadir ejemplos a cada prompt. Los pesos son los números que guardan lo que el modelo ha aprendido. Con un prompt o con RAG, el modelo es el mismo y lo que cambia es lo que tiene delante; con el fine-tuning, el que cambia es el modelo.
Por eso el fine-tuning se hace una vez, antes de usar el modelo, y lo que aprende se queda dentro hasta que se vuelve a entrenar. Lo que el agente lee en cada respuesta, en cambio, se puede cambiar cada día sin tocar nada.
¿Cómo funciona?
Microsoft distingue tres formas, según qué se le da al modelo para aprender. La más directa es el ajuste supervisado (SFT, por sus siglas en inglés): se le dan ejemplos de entrada con la respuesta buena al lado, por ejemplo mensajes de clientes y cómo los contestó bien la oficina. Sirve cuando se puede enseñar con ejemplos lo que se quiere.
La segunda es el ajuste por preferencias (DPO): para cada entrada se le dan dos respuestas, una preferida y otra rechazada, y aprende a parecerse a la primera. Encaja cuando no hay una única respuesta correcta y lo que importa es el tono o lo completa que es. La tercera es el ajuste por refuerzo (RFT): en lugar de respuestas, se le da un corrector que puntúa lo que escribe, y el modelo aprende a sacar mejor nota. Sirve cuando hay varias soluciones válidas y se puede medir bien cuál es mejor.
No siempre se reentrena el modelo entero. Las técnicas de ajuste eficiente, que IBM agrupa bajo las siglas PEFT, cambian solo una parte pequeña de los parámetros y reducen mucho el cálculo y la memoria necesarios. Una de ellas es LoRA: el ajuste se guarda como una pieza aparte que se acopla al modelo base, de modo que se pueden tener varias y cambiar de una a otra según la tarea.
¿Para qué sirve?
Según Microsoft, el fine-tuning ayuda cuando hay datos de entrenamiento buenos y específicos y se quiere una de estas cosas. Que el modelo acierte más en una tarea concreta, porque con más ejemplos de los que caben en un prompt aprende sus patrones. Que el prompt sea más corto, porque lo que antes había que explicar en cada respuesta ya lo sabe, y eso baja el coste por token y el tiempo de respuesta. Que responda siempre con el mismo tono, el mismo formato o la misma estructura.
Hay tres usos más técnicos. Mejorar cómo usa las herramientas, eligiendo la correcta y rellenando bien sus datos. Aprovechar mejor los documentos que se le pasan, aprendiendo a quedarse con lo que importa e ignorar el resto. Y especializar un modelo pequeño, más barato y más rápido, con ejemplos generados por uno grande, para que haga una tarea concreta casi igual de bien.
En una empresa de servicio técnico, eso se traduce en cosas como clasificar los avisos por tipo y urgencia con el criterio de la casa, sacar siempre los mismos campos de un correo con el mismo formato, o conseguir que un modelo pequeño y rápido haga bien una tarea muy repetida, como reconocer la marca y el código de error en el mensaje de un cliente.
¿Para qué no sirve?
Para que el modelo sepa datos que cambian. Es el malentendido más común, y Microsoft lo dice en el mismo párrafo en el que lo presenta:
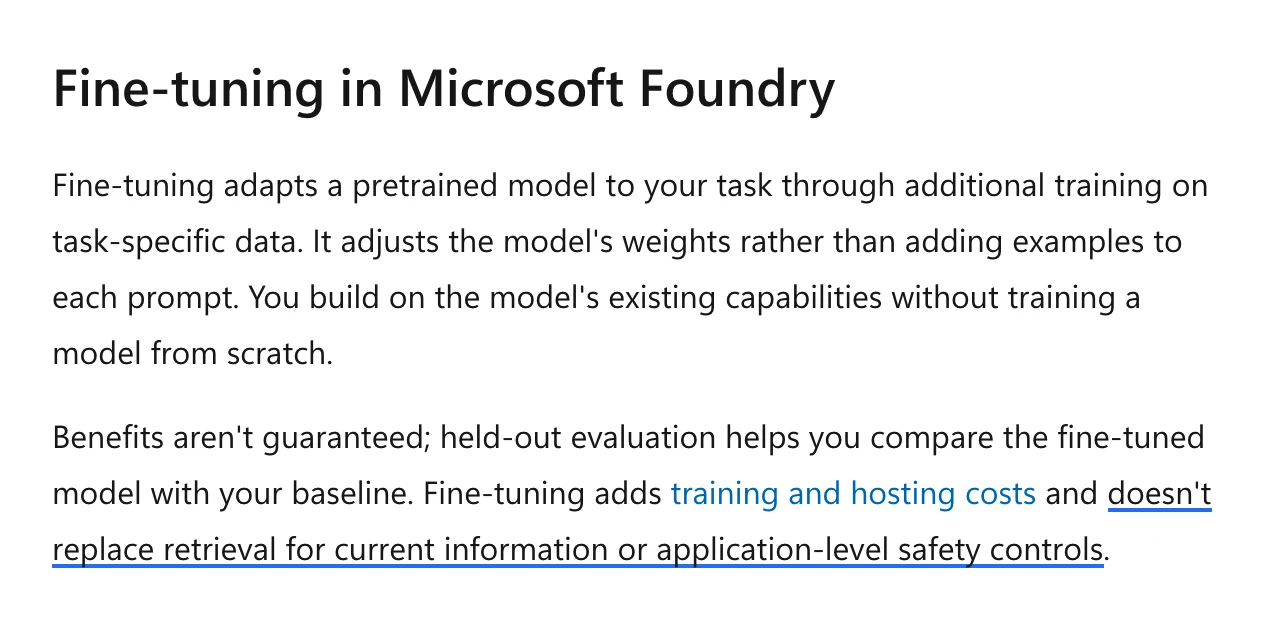
Si las tarifas cambian en enero o el técnico de guardia cambia cada semana, un modelo entrenado con los datos de diciembre seguirá diciendo lo de diciembre, con total seguridad, hasta que se vuelva a entrenar. Para eso está RAG: el agente lee el dato en vuestro programa o en vuestros documentos en el momento de contestar. Y tampoco sustituye a los controles de seguridad: lo que el agente no debe hacer nunca se controla con sus permisos y sus reglas, no esperando que lo haya aprendido.
¿Fine-tuning, RAG o prompt?
Los tres sirven para adaptar un modelo a una empresa, y casi siempre se empieza por el más barato. El prompt es lo primero: escribir bien qué tiene que hacer, qué no sabe y cómo tiene que responder resuelve una parte enorme del trabajo, y se cambia en minutos. El RAG es lo segundo, para todo lo que el agente tiene que saber de la empresa y cambia: procedimientos, tarifas, contratos, historial de cada equipo.
El fine-tuning llega después, cuando el prompt y los documentos ya están bien y aun así hay algo que el modelo no hace como se quiere: un formato que no respeta, una clasificación en la que falla siempre del mismo modo, o un coste por respuesta que solo baja con un modelo más pequeño entrenado para esa tarea. La comparación entre RAG y fine-tuning, punto por punto, está en qué es RAG.
¿Qué hace falta para hacerlo?
Lo primero son buenos ejemplos. Microsoft insiste en que sean correctos, coherentes y representativos, y en revisar antes de subirlos si faltan casos, si hay duplicados, sesgos o información sensible. En un servicio técnico, los ejemplos son conversaciones con clientes, así que llevan nombres, direcciones y teléfonos: son datos personales, y antes de usarlos para entrenar hay que tener claro el permiso y quitar lo que no haga falta.
Lo segundo es una forma de medir. Hay que separar los ejemplos de entrenamiento de los de prueba y comparar el modelo ajustado con el de partida en casos que no ha visto, no solo mirar cómo baja el error durante el entrenamiento. Microsoft lo llama un proceso de ingeniería iterativo, no una mejora garantizada.
Y lo tercero es presupuesto y mantenimiento. Hay que pagar el entrenamiento, las pruebas repetidas y, a menudo, el alojamiento del modelo ajustado. Y cuando el modelo base se retira o cambian los datos, hay que volver a entrenarlo. En Delegic, por eso, lo que sabe el agente de cada empresa vive en sus instrucciones y en sus documentos, que la empresa puede leer y corregir, y no dentro de un modelo entrenado que nadie puede abrir.
Preguntas frecuentes
¿Qué significa fine-tuning?
Es la expresión inglesa para ajuste fino: seguir entrenando un modelo ya hecho, con ejemplos propios, para afinarlo en una tarea.
¿Puedo entrenar ChatGPT con los datos de mi empresa?
Los grandes proveedores permiten hacer fine-tuning de algunos de sus modelos a través de sus plataformas para empresas. Pero si lo que se quiere es que conteste con los datos de la empresa, lo habitual y más barato es RAG: darle los documentos en el momento de responder, sin entrenar nada.
¿Cuántos ejemplos hacen falta?
Depende de la tarea y del modelo, y no hay una cifra que valga para todo. Lo que sí repiten las guías es que importan más la calidad y la variedad que la cantidad, y que siempre hay que guardar una parte para probar.
¿Qué es LoRA?
Una técnica de ajuste eficiente que no cambia el modelo entero: guarda el ajuste como una pieza pequeña aparte que se acopla al modelo base. Es más barata de entrenar y permite tener varias piezas para tareas distintas.
Términos relacionados
- LLM: el modelo que se ajusta.
- RAG: darle los documentos en cada respuesta, sin entrenar.
- Prompt: las instrucciones que lee el modelo antes de responder.
- Evaluación: cómo se comprueba si un cambio mejora o empeora.
- Embeddings: los números con los que el RAG clásico busca por parecido.